Vì sao tương lai của AI không chỉ nằm ở những mô hình thông minh hơn, mà còn ở cách chúng ta tổ chức công việc xung quanh chúng?
Mỗi khi một mô hình mới xuất hiện, chúng ta thường dành rất nhiều thời gian để tìm hiểu xem nó thông minh hơn mô hình cũ bao nhiêu.
Nó viết code tốt hơn không? Khả năng suy luận có cải thiện không? Nó có thể xử lý những nhiệm vụ dài hơn không? Hay liệu nó đã đủ khả năng thay thế những công việc mà trước đây chúng ta phải tự thực hiện?
Tôi cũng từng rất quan tâm đến những câu hỏi ấy.
Nhưng càng sử dụng AI nhiều, tôi càng cảm thấy rằng năng lực của mô hình chỉ là một phần của câu chuyện.
Cùng một mô hình, có người chỉ sử dụng để hỏi đáp, viết vài đoạn văn hoặc sửa một đoạn code nhỏ. Trong khi đó, người khác có thể dùng nó để xây dựng cả ứng dụng, kiểm tra hệ thống, xử lý hàng chục nhiệm vụ song song và tự động hóa những công việc lặp lại mỗi ngày.
Sự khác biệt không chỉ nằm ở việc ai viết prompt tốt hơn.
Nó còn nằm ở việc chúng ta cho AI tiếp cận những thông tin gì, sử dụng những công cụ nào, hoạt động trong môi trường ra sao và có thể tự thực hiện công việc đến mức nào.
Điều này khiến tôi nhớ đến những ngày đầu sử dụng ChatGPT 3.5.
Khi đó, tôi thường nhờ AI viết một đoạn Google Apps Script để dán vào Google Sheets. Nếu code không chạy, tôi sao chép thông báo lỗi, gửi lại cho ChatGPT rồi chờ nó đưa ra phiên bản mới.
Cứ như vậy, tôi là người liên tục chuyển thông tin giữa AI và môi trường thực tế.
AI viết code, tôi chạy thử.
AI đề xuất cách sửa, tôi áp dụng.
AI cần biết lỗi gì xảy ra, tôi phải tự sao chép thông báo lỗi gửi cho nó.
Nhìn lại, tôi nhận ra bản thân khi ấy chính là một phần trong quy trình vận hành của AI.
Nếu tôi không tiếp tục gửi tin nhắn, công việc sẽ dừng lại.
Ngày nay, với những công cụ như Claude Code hay Codex, AI có thể tự mở file, chạy chương trình, đọc thông báo lỗi, sửa code rồi kiểm thử lại.
Và khi có thêm cơ chế tự động hóa, nó thậm chí có thể tiếp tục làm việc mà không cần chúng ta liên tục ngồi trước màn hình.
Gần đây, tôi đọc một bài viết của Livsun (@L1vsun), đăng ngày 31/10, có tiêu đề Prompt → Context → Harness → Loop → Graph: The 5 Levels of AI Engineering.
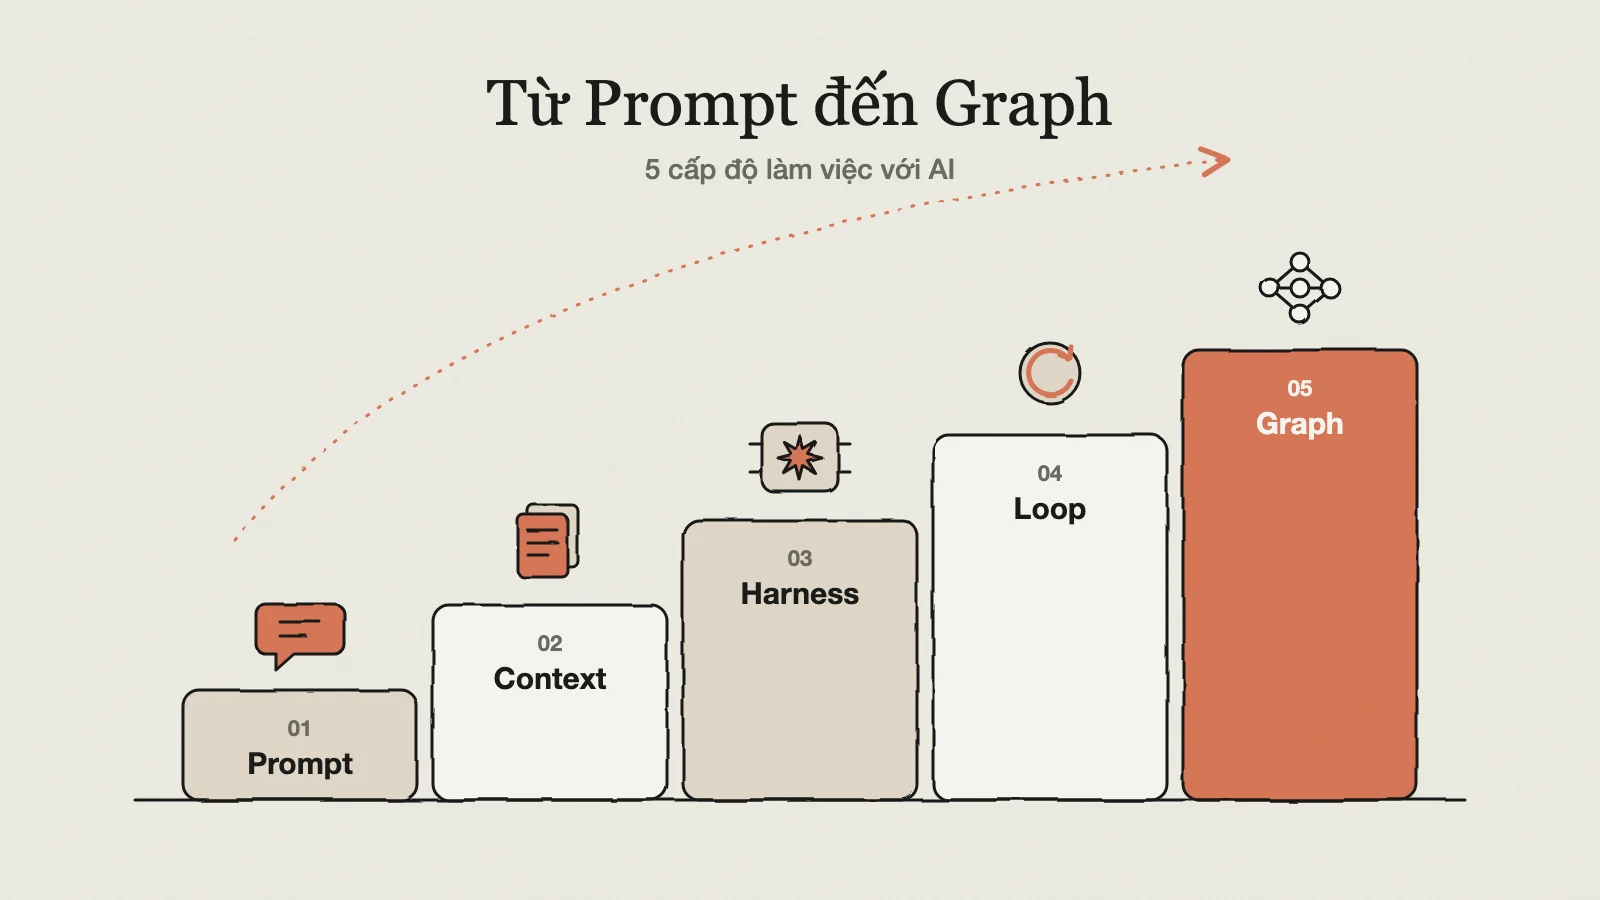
Tác giả đưa ra một cách phân chia khá thú vị: Có năm cấp độ trong cách chúng ta làm việc với AI, bắt đầu từ việc viết prompt và kết thúc ở việc thiết kế những hệ thống có thể điều phối nhiều AI Agents cùng thực hiện một công việc.
Điều tôi thích ở cách phân chia này là nó không phụ thuộc quá nhiều vào một mô hình cụ thể.
Claude, GPT hay Gemini sẽ tiếp tục được nâng cấp. Những công cụ chúng ta sử dụng hôm nay có thể trở nên lỗi thời chỉ sau vài tháng.
Nhưng những nguyên tắc về cách cung cấp thông tin, xây dựng môi trường, tổ chức quy trình và phân chia công việc có lẽ sẽ còn hữu ích lâu hơn.
Và tôi nghĩ đây là một cách khá hay để nhìn lại xem chúng ta đang thực sự sử dụng AI ở cấp độ nào.
1. Prompt Engineering: Khi chính chúng ta là vòng lặp của AI
Đây là cấp độ mà hầu hết mọi người đều quen thuộc.
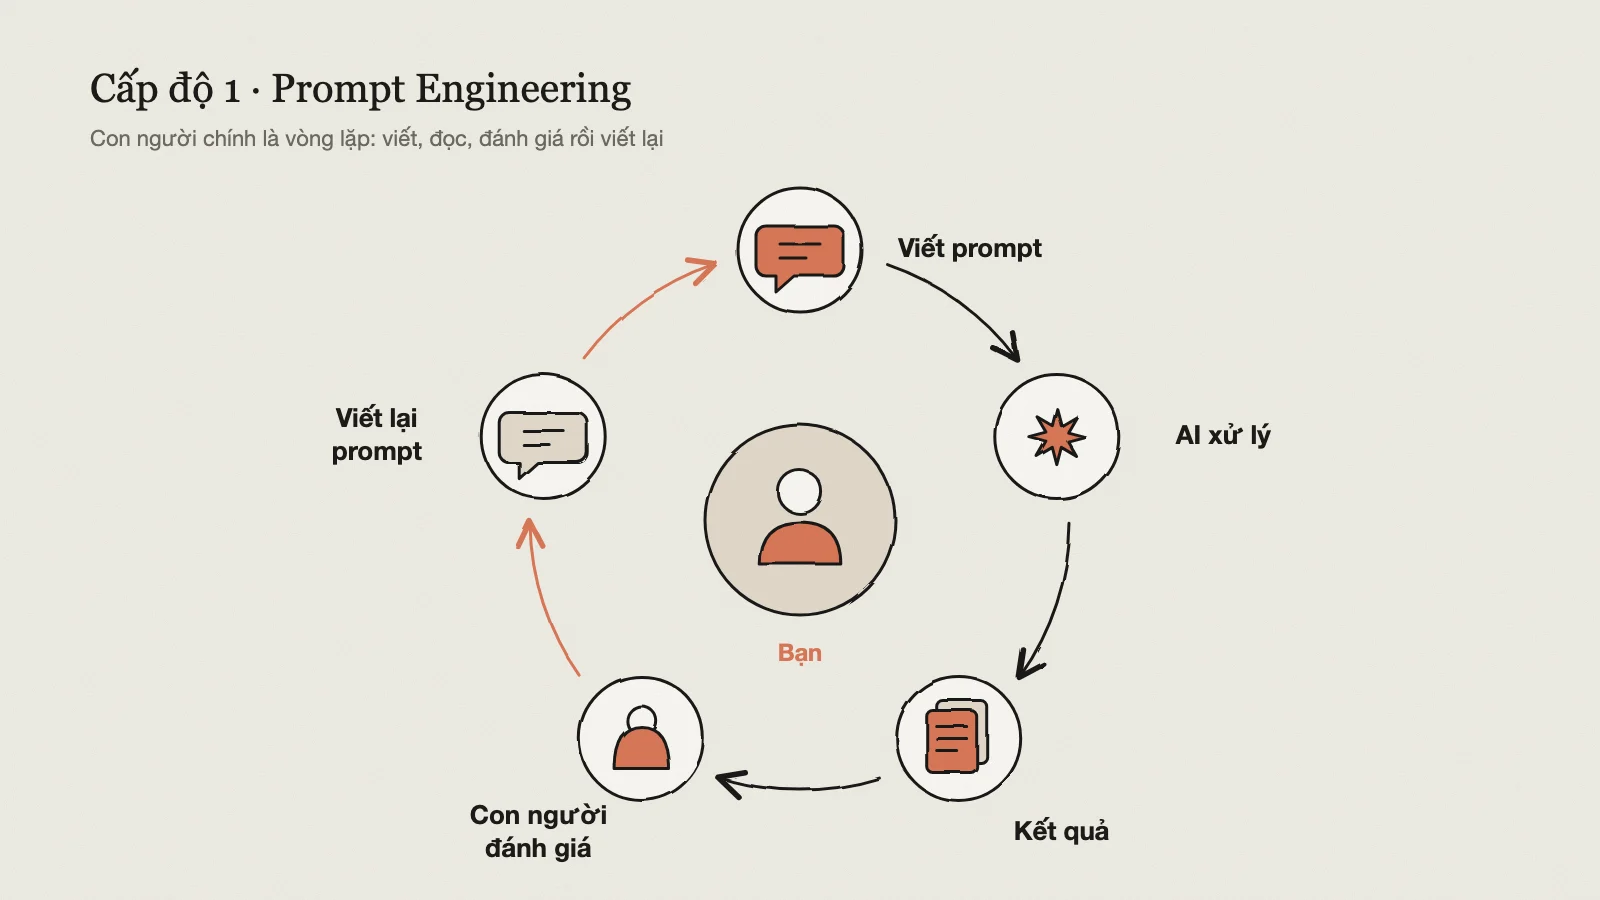
Chúng ta mở ChatGPT, Claude hoặc một công cụ tương tự, nhập yêu cầu rồi chờ câu trả lời.
Nếu kết quả chưa đúng, chúng ta sửa lại prompt.
Nếu AI hiểu sai, chúng ta giải thích kỹ hơn.
Nếu vẫn chưa đạt yêu cầu, chúng ta thử một cách diễn đạt khác.
Quy trình ấy cứ lặp đi lặp lại cho đến khi có được kết quả mong muốn.
Không có gì sai với cách làm này.
Trên thực tế, nó vẫn rất hữu ích đối với những nhiệm vụ đơn giản như giải thích khái niệm, dịch thuật, viết nội dung hoặc giải quyết một câu hỏi cụ thể.
Nhưng khi công việc trở nên phức tạp, điểm yếu của cách tiếp cận này bắt đầu xuất hiện.
Tác giả chỉ ra một điều khá thú vị: Thành phần chậm nhất trong toàn bộ hệ thống chính là con người.
AI có thể tạo ra câu trả lời trong vài giây.
Nhưng chúng ta cần thời gian để đọc, suy nghĩ, đánh giá, viết lại yêu cầu rồi gửi tiếp.
Mỗi lần thử lại đều phải chờ con người.
Tôi nghĩ ví dụ rõ ràng nhất chính là việc sử dụng AI để lập trình theo cách truyền thống.
Giả sử tôi muốn tạo một tính năng mới cho website.
Tôi yêu cầu AI viết code.
Sau đó sao chép code vào dự án, chạy thử, phát hiện lỗi, quay lại cuộc trò chuyện, mô tả lỗi rồi chờ AI sửa.
Nếu gặp thêm vấn đề, tôi tiếp tục lặp lại quá trình ấy.
Về bản chất, AI chưa thực sự tự giải quyết vấn đề.
Nó chỉ đang hỗ trợ tôi thực hiện từng bước nhỏ.
Khi prompt trở thành thứ chúng ta quá phụ thuộc
Một dấu hiệu khá rõ của cấp độ này là chúng ta luôn tìm kiếm những câu lệnh được cho là có khả năng khiến AI thông minh hơn.
Chẳng hạn:
“Hãy suy nghĩ từng bước.”
“Bạn là một chuyên gia hàng đầu thế giới.”
“Hãy đóng vai một kỹ sư phần mềm có 20 năm kinh nghiệm.”
Hoặc những bộ prompt dài hàng nghìn từ được lưu trong Notion để sao chép mỗi khi cần.
Tôi không nghĩ những kỹ thuật ấy hoàn toàn vô ích.
Cách diễn đạt yêu cầu vẫn có thể ảnh hưởng đến chất lượng câu trả lời.
Nhưng vấn đề là một prompt, dù được viết tốt đến đâu, cũng không thể cung cấp cho AI những thông tin mà nó chưa được nhìn thấy.
Nó không thể tự biết cấu trúc dự án của chúng ta nếu không được cung cấp.
Nó không thể kiểm tra một chương trình có chạy đúng hay không nếu không có công cụ để chạy.
Và nó không thể biết lỗi thực tế của hệ thống nếu chúng ta chỉ mô tả vấn đề bằng vài câu chung chung.
Vì vậy, tác giả đề xuất một câu hỏi rất đáng để thử.
Lần tới, khi AI đưa ra kết quả sai, đừng vội viết lại prompt.
Hãy tự hỏi:
“AI cần được nhìn thấy điều gì để có thể làm đúng ngay từ đầu?”
Nếu câu trả lời là một file, một tài liệu, một ví dụ, một quy tắc hoặc một thông tin về trạng thái hệ thống, có lẽ vấn đề chưa bao giờ nằm ở prompt.
Nó nằm ở context.
Và đó là cấp độ thứ hai.
2. Context Engineering: Thay vì viết câu lệnh hay hơn, hãy cung cấp đúng thông tin
Tháng 6/2025, CEO Shopify, Tobi Lütke, chia sẻ rằng ông thích khái niệm Context Engineering hơn Prompt Engineering.
Theo ông, thuật ngữ này mô tả chính xác hơn kỹ năng cốt lõi khi làm việc với mô hình ngôn ngữ: Nghệ thuật cung cấp đủ ngữ cảnh để mô hình có khả năng giải quyết nhiệm vụ.
Andrej Karpathy sau đó đồng tình và đưa ra một định nghĩa được trích dẫn khá nhiều:
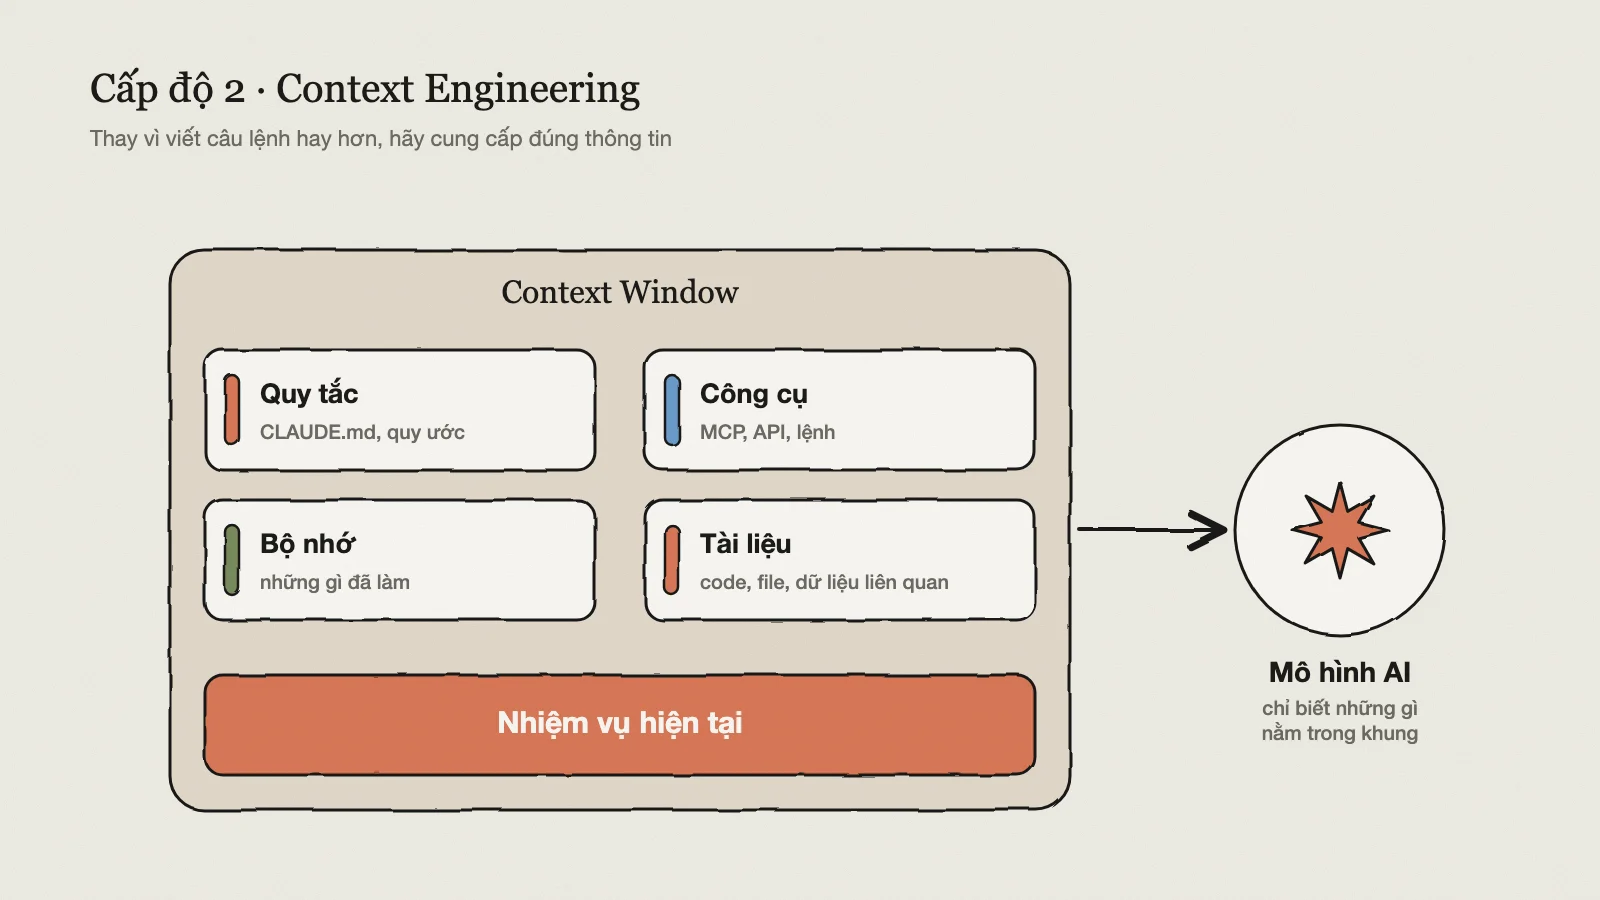
Context Engineering là nghệ thuật và khoa học tinh tế của việc đưa đúng thông tin vào cửa sổ ngữ cảnh, phục vụ cho bước tiếp theo.
Tôi nghĩ phần quan trọng nhất nằm ở cụm từ “bước tiếp theo”.
Bởi AI không tự nhiên biết mọi thứ về dự án mà chúng ta đang làm.
Nó không biết những quyết định đã được đưa ra hôm qua.
Không biết vì sao chúng ta chọn công nghệ này thay vì công nghệ khác.
Không biết những quy tắc riêng của dự án.
Và cũng không biết vấn đề nào vừa xảy ra trong hệ thống, trừ khi những thông tin ấy được đưa vào ngữ cảnh mà nó có thể sử dụng.
Ở cấp độ này, chúng ta bắt đầu chuyển sự chú ý từ cách viết câu lệnh sang cách tổ chức thông tin.
Những gì AI cần biết trước khi bắt đầu
Tác giả chia context thành một số thành phần quan trọng.
Đầu tiên là những quy tắc tương đối ổn định, chẳng hạn system prompt hoặc một file hướng dẫn dự án như CLAUDE.md.
File này có thể mô tả công nghệ đang sử dụng, cấu trúc thư mục, quy ước lập trình, những điều cần tránh và cách chạy kiểm thử.
Tiếp theo là thông tin về công cụ.
AI cần biết những công cụ nào có sẵn, chúng dùng để làm gì và trong trường hợp nào nên sử dụng công cụ nào.
Sau đó là bộ nhớ.
Những quyết định đã được đưa ra, những vấn đề đã giải quyết và trạng thái công việc từ các phiên trước cần được lưu lại để AI không phải liên tục bắt đầu từ con số không.
Một thành phần khác là tài liệu được truy xuất khi cần.
Thay vì đưa toàn bộ 300 file tài liệu vào context, chúng ta chỉ nên cung cấp ba file thực sự liên quan đến nhiệm vụ hiện tại.
Cuối cùng mới là yêu cầu cụ thể cần thực hiện.
Điều này khiến tôi nghĩ đến một sự khác biệt khá lớn giữa hai cách sử dụng AI.
Ở cấp độ 1, chúng ta cố gắng viết một câu lệnh thật hoàn hảo.
Ở cấp độ 2, chúng ta cố gắng xây dựng một môi trường thông tin đủ tốt để ngay cả một câu lệnh tương đối ngắn cũng có thể tạo ra kết quả chính xác.
Ví dụ, thay vì viết một prompt dài giải thích lại toàn bộ kiến trúc website mỗi khi cần sửa một tính năng, chúng ta có thể lưu kiến trúc ấy vào tài liệu dự án.
Khi cần thực hiện công việc, AI chỉ cần đọc những tài liệu phù hợp.
Cách làm này không chỉ tiết kiệm thời gian.
Nó còn giúp giảm nguy cơ chúng ta quên cung cấp một chi tiết quan trọng.
Nhưng context vẫn chưa đủ
Dù vậy, Context Engineering vẫn có một giới hạn.
AI có thể được cung cấp đầy đủ tài liệu, hiểu rõ dự án và biết chính xác nhiệm vụ cần làm.
Nhưng nếu nó không thể tự mở file, chạy code hoặc kiểm tra kết quả, con người vẫn phải đứng giữa.
Chúng ta vẫn là người chuẩn bị môi trường và thực hiện các thao tác.
Muốn AI thực sự hành động, chúng ta cần thêm một lớp hệ thống khác.
Tác giả gọi đó là Harness Engineering.
3. Harness Engineering: Mô hình là động cơ, còn Harness là cả chiếc xe
Tôi thấy đây là một trong những khái niệm quan trọng nhất của bài viết.
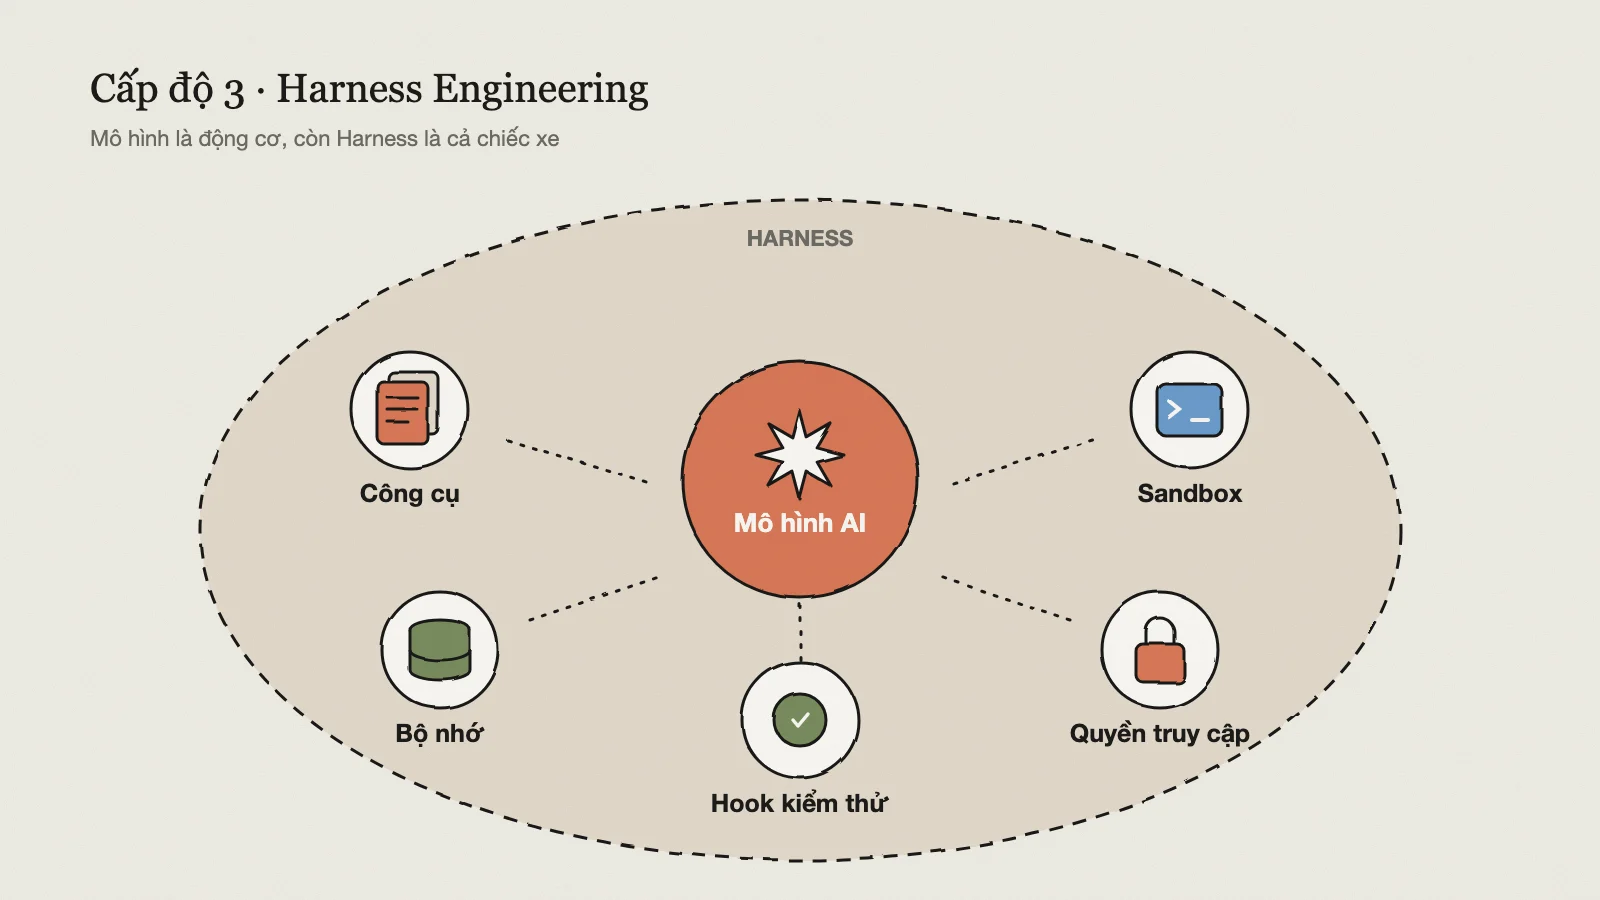
Nếu ví mô hình AI như một động cơ, thì harness chính là toàn bộ chiếc xe được xây dựng xung quanh động cơ ấy.
Một động cơ mạnh chưa đủ để đưa chúng ta đến nơi cần đến.
Nó còn cần hệ thống điều khiển, bánh xe, phanh, cảm biến và những cơ chế giúp vận hành an toàn.
Tương tự, một mô hình ngôn ngữ dù thông minh đến đâu cũng chưa tự động trở thành một AI Agent có thể làm việc độc lập.
Nó cần một môi trường để hành động.
Trong bài viết, harness bao gồm những thành phần như vòng lặp gửi kết quả công cụ trở lại mô hình, hệ thống công cụ, quyền truy cập, môi trường sandbox, file bộ nhớ, các hook kích hoạt theo sự kiện và lịch sử ghi lại những gì đã xảy ra.
Claude Code là một harness.
Codex CLI cũng là một harness.
Và một điều khá thú vị là nếu đặt cùng một mô hình vào hai harness khác nhau, chúng ta có thể nhận được hai Agent có khả năng làm việc rất khác nhau.
Điều này giải thích vì sao đôi khi chúng ta thấy hai công cụ sử dụng mô hình tương đương nhưng lại cho kết quả khác biệt đáng kể trong những nhiệm vụ lập trình thực tế.
Sự khác biệt không nhất thiết nằm ở trí thông minh của mô hình.
Nó có thể nằm ở cách công cụ cho phép mô hình quan sát môi trường, sử dụng terminal, sửa file, quản lý bộ nhớ và tự kiểm tra công việc.
Khi cải thiện môi trường đem lại hiệu quả lớn hơn cải thiện prompt
Tác giả nhắc đến một bài viết của OpenAI vào tháng 2 về Harness Engineering trong môi trường phát triển phần mềm sử dụng Codex.
Trong trường hợp được mô tả, một repository phát triển lên khoảng một triệu dòng code chỉ trong năm tháng, với Codex đảm nhận phần lớn việc viết code, còn các kỹ sư tập trung thiết kế môi trường mà Agent hoạt động.
Một nghiên cứu khác, Agentic Harness Engineering, của các nhà nghiên cứu từ Đại học Phúc Đán và Đại học Bắc Kinh, tiếp tục đưa ra những kết quả định lượng.
Trong thí nghiệm, một Agent được giao nhiệm vụ liên tục chỉnh sửa harness của một coding Agent khác, sau đó kiểm tra kết quả so với dự đoán.
Sau mười vòng cải tiến, kết quả được tác giả dẫn lại như sau:
- Tỷ lệ thành công pass@1 trên Terminal-Bench 2 tăng từ 69,7% lên 77,0%.
- Kết quả vượt mức 71,9% của harness Codex CLI do con người thiết kế trong phép so sánh được nêu.
- Harness sau khi hoàn thiện sử dụng ít hơn 12% token trên SWE-bench Verified.
- Phần lớn cải thiện đến từ công cụ, middleware và bộ nhớ dài hạn, thay vì chỉnh sửa system prompt.
Tôi nghĩ đây là một ví dụ khá rõ về việc chúng ta có thể đang tập trung quá nhiều vào một phần nhỏ của hệ thống.
Nếu một mô hình đã đủ mạnh, việc viết thêm vài câu hướng dẫn có thể không tạo ra khác biệt lớn bằng việc cho nó một môi trường làm việc tốt hơn.
Đừng để AI tự quyết định rằng nó đã hoàn thành
Một ví dụ thực tế mà tác giả đưa ra là sử dụng Stop hook trong Claude Code.
Thông thường, một Agent có thể kết thúc công việc khi nó cho rằng nhiệm vụ đã hoàn thành.
Nhưng cảm giác “đã xong” của mô hình không phải bằng chứng cho thấy code thực sự hoạt động.
Vì vậy, chúng ta có thể thiết lập một hook để mỗi khi Agent muốn dừng lại, hệ thống sẽ tự động chạy bộ kiểm thử.
Nếu kiểm thử thất bại, Agent không được phép kết thúc.
Ví dụ cấu hình:
{
  "hooks": {
    "Stop": [
      {
        "hooks": [
          {
            "type": "command",
            "command": "npm test --silent >&2 || exit 2"
          }
        ]
      }
    ]
  }
}
Trong ví dụ này, lệnh npm test được chạy khi Agent cố gắng kết thúc.
Nếu kiểm thử thất bại, hook trả về mã thoát 2 để chặn việc dừng và chuyển thông tin lỗi lại cho mô hình.
Điểm thú vị nằm ở sự thay đổi trong cách định nghĩa hoàn thành công việc.
Trước đây, “hoàn thành” có thể chỉ đơn giản là AI nói rằng nó đã sửa xong.
Giờ đây, “hoàn thành” có nghĩa là bộ kiểm thử phải chạy thành công.
Tất nhiên, một bộ kiểm thử không đầy đủ vẫn có thể bỏ sót lỗi. Nhưng ít nhất, chúng ta đã tạo ra một cơ chế kiểm chứng độc lập với lời khẳng định của AI.
Tôi nghĩ đây là một bước rất quan trọng.
Thay vì cố gắng khiến AI luôn đưa ra quyết định đúng, chúng ta xây dựng một môi trường khiến những quyết định sai có cơ hội được phát hiện và sửa chữa.
Tuy nhiên, ngay cả một harness rất tốt vẫn còn một giới hạn.
Agent có thể tự thực hiện nhiệm vụ, sử dụng công cụ và kiểm tra kết quả.
Nhưng ai là người bắt đầu công việc?
Thông thường vẫn là chúng ta.
Và đó là lúc xuất hiện cấp độ thứ tư.
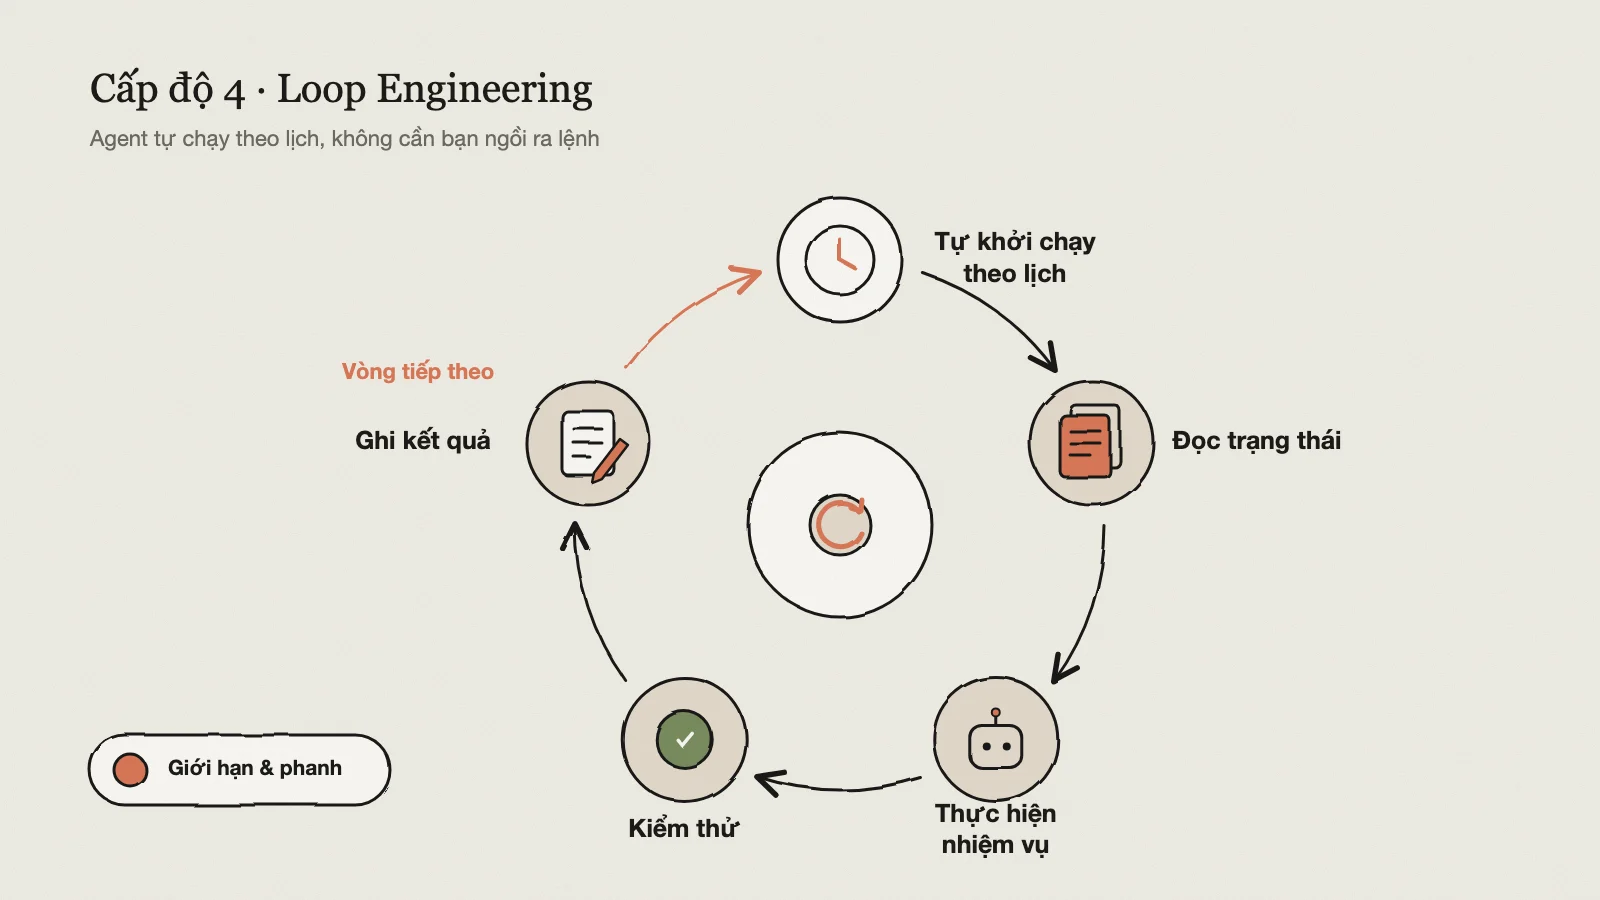
4. Loop Engineering: Khi chúng ta không còn là người phải liên tục ra lệnh
Ngày 7/6, Addy Osmani giới thiệu khái niệm Loop Engineering trong bài viết Loop Engineering: Designing loops that prompt coding agents.
Theo cách diễn đạt của ông, Loop Engineering là việc thay thế chính bản thân mình trong vai trò người liên tục gửi prompt cho Agent.
Ông đặt nó ở một tầng phía trên Harness Engineering.
Peter Steinberger cũng từng đưa ra một quan điểm tương tự: Chúng ta không nên tiếp tục trực tiếp prompt coding agents nữa, mà nên thiết kế những vòng lặp có khả năng tự prompt chúng.
Boris Cherny, người tạo ra Claude Code, cũng chia sẻ rằng công việc của anh giờ đây không còn là trực tiếp prompt Claude, mà là viết những vòng lặp.
Tôi nghĩ đây là một sự thay đổi khá thú vị.
Ở cấp độ 1, chúng ta chính là vòng lặp.
Chúng ta đọc kết quả, đánh giá, sửa yêu cầu rồi gửi tiếp.
Ở cấp độ 3, harness đã có thể tự thực hiện nhiều vòng thao tác trong một nhiệm vụ.
Nhưng chúng ta vẫn phải chủ động bắt đầu mỗi lần làm việc.
Đến cấp độ 4, ngay cả việc bắt đầu công việc cũng có thể được tự động hóa.
Một vòng lặp Agent cần những gì?
Theo Addy Osmani, một hệ thống như vậy có thể bao gồm năm thành phần chính cùng một nơi lưu trạng thái.
Thứ nhất là automation, giúp Agent tự khởi chạy theo lịch để tìm kiếm và xử lý công việc.
Thứ hai là worktree, cho phép nhiều Agent làm việc trên những nhánh hoặc không gian file độc lập, tránh xung đột khi chỉnh sửa code.
Thứ ba là skills, nơi lưu những kiến thức và quy trình mà Agent có thể nạp khi cần.
Thứ tư là plugins và connectors, giúp Agent kết nối với những công cụ mà chúng ta đang sử dụng.
Thứ năm là sub-agents, cho phép phân chia nhiệm vụ, chẳng hạn một Agent đề xuất giải pháp và một Agent khác kiểm tra giải pháp đó.
Cuối cùng là một nơi lưu trạng thái, có thể chỉ là file Markdown hoặc một bảng công việc, ghi lại những gì đã hoàn thành và những gì cần làm tiếp.
Điều này giúp Agent không phải bắt đầu lại từ đầu sau mỗi lần chạy.
Một ví dụ đơn giản với Claude Code
Tác giả đưa ra một ví dụ sử dụng lệnh /loop:
/loop 30m read STATE.md, pick the top open bug, fix it in a worktree,
run the tests, open a PR, then write what you did back into STATE.md
Ý tưởng khá dễ hiểu.
Cứ mỗi 30 phút, Agent sẽ đọc file STATE.md, tìm lỗi chưa được xử lý có mức ưu tiên cao nhất, sửa lỗi trong một worktree riêng, chạy kiểm thử, tạo pull request rồi ghi lại kết quả vào file trạng thái.
Chúng ta không cần liên tục quay lại và nhắc nó thực hiện bước tiếp theo.
Và nếu tổ chức tốt, một quy trình như vậy có thể xử lý nhiều công việc lặp lại mà không cần sự can thiệp thường xuyên của con người.
Tôi nghĩ đây là lúc AI bắt đầu giống một hệ thống tự động hóa thực sự, thay vì một công cụ chỉ phản hồi khi được hỏi.
Nhưng một vòng lặp không có phanh có thể trở thành vấn đề
Tác giả cũng đưa ra một cảnh báo khá quan trọng.
Một Agent thông thường có thể kết thúc khi mô hình không còn yêu cầu sử dụng công cụ.
Nếu chúng ta chỉ đơn giản đặt quá trình đó vào một lịch chạy định kỳ, hệ thống có thể tiếp tục hoạt động trong nhiều giờ, tiêu tốn tài nguyên và chi phí mà không tạo ra giá trị tương ứng.
Vì vậy, một vòng lặp tốt cần có những cơ chế dừng rõ ràng.
Chẳng hạn, điều kiện hoàn thành phải được kiểm tra bên ngoài mô hình, giống Stop hook ở cấp độ 3.
Hệ thống cần có ngân sách tối đa về số lần chạy, số token hoặc số tiền được phép sử dụng.
Nếu hai vòng liên tiếp không tìm thấy công việc mới, vòng lặp nên dừng.
Và sau mỗi bước, trạng thái cần được lưu lại để nếu hệ thống gặp sự cố, nó có thể tiếp tục từ vị trí trước đó thay vì làm lại mọi thứ.
Tôi nghĩ đây là một điểm rất đáng chú ý.
Khi AI bắt đầu làm việc tự động, vấn đề không còn chỉ là nó có thể thực hiện nhiệm vụ hay không.
Chúng ta còn phải quan tâm đến việc nó có biết khi nào nên dừng lại, khi nào cần báo cáo và khi nào cần yêu cầu con người đưa ra quyết định.
Addy Osmani cũng nhấn mạnh rằng Loop Engineering không đồng nghĩa với việc trao toàn bộ quyền tự chủ cho AI.
Con người vẫn cần kiểm tra kết quả và sử dụng khả năng phán đoán của mình.
Vòng lặp tự động loại bỏ việc phải liên tục gõ lệnh, chứ không loại bỏ trách nhiệm suy nghĩ.
Nhưng cấp độ này vẫn có một giới hạn.
Một vòng lặp thường xử lý công việc theo một luồng tương đối tuyến tính.
Nếu cần kiểm tra 40 file, đọc 12 nguồn tài liệu hoặc đánh giá hàng trăm thành phần, việc thực hiện tuần tự có thể mất rất nhiều thời gian.
Và đó là lý do tác giả đưa ra cấp độ cuối cùng.
5. Graph Engineering: Thay vì thiết kế từng bước, hãy thiết kế hình dạng của công việc
Đây có lẽ là cấp độ thú vị nhất trong toàn bộ bài viết.
Ở bốn cấp độ trước, chúng ta chủ yếu quan tâm đến việc làm sao để một Agent thực hiện công việc hiệu quả hơn.
Nhưng ở cấp độ 5, câu hỏi bắt đầu thay đổi.
Thay vì hỏi một Agent nên thực hiện những bước nào, chúng ta hỏi:
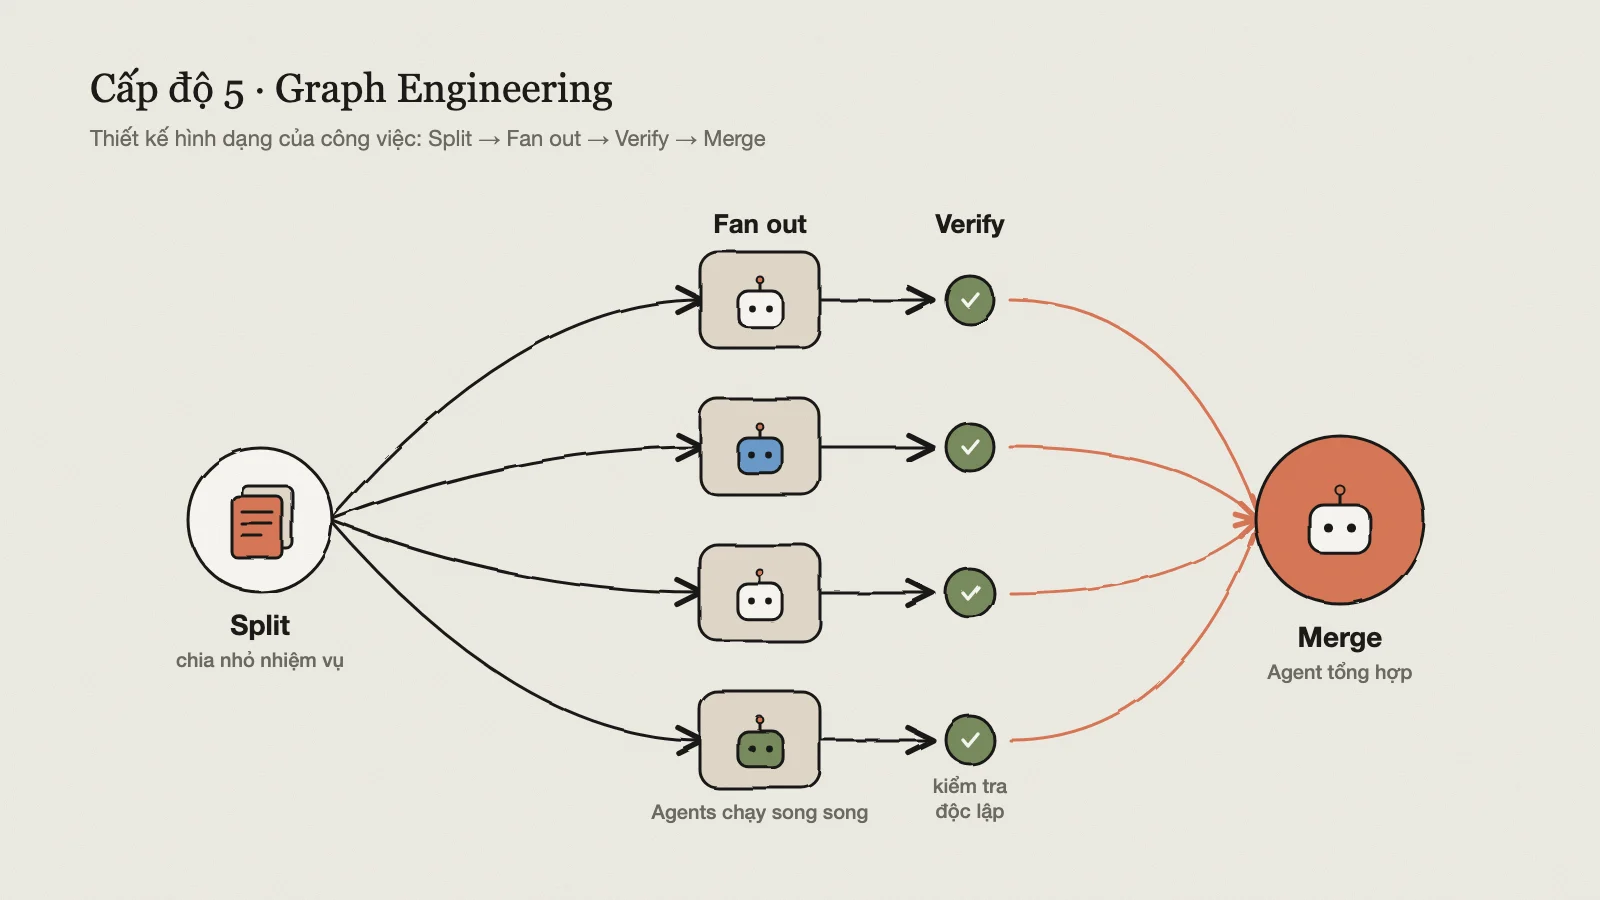
Công việc này nên được chia thành những phần nào, phần nào phụ thuộc vào phần nào và những phần nào có thể thực hiện song song?
Tác giả gọi đây là Graph Engineering.
Trong cách tiếp cận này, công việc được biểu diễn thành một đồ thị gồm các node và edge.
Mỗi node là một nhiệm vụ có phạm vi rõ ràng, với đầu vào và đầu ra xác định.
Một edge chỉ tồn tại khi đầu ra của node này thực sự cần thiết cho đầu vào của node khác.
Nghe có vẻ khá trừu tượng, nhưng ví dụ của tác giả rất dễ hiểu.
Không phải công việc nào cũng cần thực hiện tuần tự
Giả sử chúng ta muốn kiểm tra 40 file trong một dự án.
Một cách làm đơn giản là yêu cầu Agent đọc file thứ nhất, sau đó file thứ hai, rồi file thứ ba, cứ như vậy cho đến hết.
Nhưng liệu việc kiểm tra file thứ hai có thực sự phụ thuộc vào kết quả kiểm tra file thứ nhất không?
Trong nhiều trường hợp, câu trả lời là không.
Nếu các nhiệm vụ độc lập, không có lý do gì chúng phải xếp hàng chờ nhau.
Tác giả cho rằng rất nhiều quy trình Agent kiểu “bước 1, rồi bước 2, rồi bước 3” thực chất chứa những mối quan hệ phụ thuộc không cần thiết.
Khi loại bỏ những mối quan hệ giả ấy, quy trình có thể chuyển từ một đường thẳng thành một cấu trúc hình kim cương.
Cấu trúc đó gồm bốn giai đoạn.
Split: Một Agent chia nhiệm vụ lớn thành những phần nhỏ độc lập.
Fan out: Nhiều Agent thực hiện các phần việc cùng lúc, mỗi Agent có ngữ cảnh riêng.
Verify: Những Agent kiểm chứng tìm cách bác bỏ các phát hiện trước khi chúng được chấp nhận.
Merge: Một Agent cuối cùng tổng hợp những kết quả đã vượt qua bước kiểm chứng thành báo cáo hoàn chỉnh.
Điều tôi thích ở cách làm này là nó không chỉ giúp tăng tốc độ.
Nó còn tạo ra một cơ chế kiểm tra chất lượng ngay trong cấu trúc công việc.
Thay vì để một Agent tự đưa ra kết luận rồi tự tin rằng mình đúng, chúng ta có thể yêu cầu một Agent khác chủ động tìm lý do khiến kết luận ấy sai.
Tôi nghĩ đây là một cách khá hay để giảm bớt những lỗi mà AI có thể mắc phải khi phân tích những nhiệm vụ lớn.
Khi nhiều Agents cùng làm việc trong một quy trình
Tác giả đề cập đến các workflow động của Claude Code ở dạng research preview, cho phép Claude viết kế hoạch thành một script JavaScript rồi điều phối nhiều sub-agents thực hiện.
Theo bài viết, số lượng sub-agents trong một phiên có thể từ hàng chục đến hàng trăm.
Điểm quan trọng là việc điều phối được mô tả bằng code.
Thay vì liên tục sử dụng thêm những lượt gọi mô hình để quyết định Agent tiếp theo cần làm gì, các mối quan hệ giữa những nhiệm vụ được xác định rõ ràng trong chương trình.
Tác giả minh họa cấu trúc kim cương bằng đoạn code sau:
// split → fan out → verify → merge

const parts = await agent(
  `Split this audit into independent parts: ${task}`,
  { schema: PARTS }
);

const findings = (
  await parallel(
    parts.items.map((part) => () =>
      agent(`Audit ${part.path}. Return every finding.`, {
        schema: FINDINGS
      })
    )
  )
)
  .filter(Boolean)
  .flatMap((result) => result.items);

const verified = (
  await parallel(
    findings.map((finding) => () =>
      agent(`Try to disprove this finding: ${finding.claim}`, {
        schema: VERDICT
      })
    )
  )
).filter((verdict) => verdict?.holds);

return agent(
  `Write the report from these verified findings: ${JSON.stringify(verified)}`
);
Đây là đoạn mã minh họa cho cấu trúc workflow, không phải một chương trình độc lập có thể chạy ngay mà không cần định nghĩa thêm các hàm và schema liên quan.
Nhưng ý tưởng của nó khá rõ ràng.
Đầu tiên, Agent chia công việc kiểm tra thành những phần độc lập.
Sau đó, nhiều Agent cùng thực hiện kiểm tra.
Những phát hiện được chuyển đến một nhóm Agent khác, có nhiệm vụ tìm cách chứng minh rằng các phát hiện ấy không chính xác.
Chỉ những kết quả vượt qua bước kiểm chứng mới được chuyển đến Agent tổng hợp cuối cùng.
Tôi nghĩ đây là một ví dụ khá rõ về sự khác biệt giữa sử dụng nhiều Agent và thực sự thiết kế một hệ thống nhiều Agent.
Chúng ta không đơn giản tạo ra thật nhiều cuộc trò chuyện rồi hy vọng chúng sẽ phối hợp tốt với nhau.
Chúng ta xác định rõ nhiệm vụ, đầu vào, đầu ra, mối quan hệ phụ thuộc và cơ chế kiểm chứng.
Làm sao để hệ thống nhiều Agents không trở nên quá đắt đỏ?
Tác giả đưa ra hai nguyên tắc.
Thứ nhất, chỉ chờ tất cả kết quả khi một nhiệm vụ thực sự cần đầy đủ dữ liệu.
Ví dụ, nếu muốn loại bỏ những phát hiện trùng lặp hoặc xếp hạng tất cả kết quả, chúng ta có thể cần đợi mọi Agent hoàn thành.
Nhưng nếu mỗi phát hiện có thể được kiểm chứng độc lập, không có lý do gì phải đợi toàn bộ quá trình kiểm tra kết thúc mới bắt đầu xác minh.
Kết quả nào xuất hiện trước có thể được chuyển sang bước tiếp theo trước.
Thứ hai là sử dụng mô hình theo từng cấp độ nhiệm vụ.
Những công việc lặp lại, tương đối đơn giản có thể giao cho mô hình rẻ hơn.
Những quyết định quan trọng, công việc kiểm chứng hoặc bước tổng hợp cuối cùng có thể sử dụng mô hình mạnh nhất.
Tôi nghĩ đây là một điểm khá thực tế.
Một hệ thống nhiều Agent không nhất thiết phải sử dụng mô hình đắt nhất cho mọi nhiệm vụ.
Điều quan trọng là phân bổ năng lực và chi phí phù hợp với mức độ khó và rủi ro của từng phần công việc.
6. Chúng ta đang ở cấp độ nào?
Sau khi đi qua cả năm cấp độ, tác giả đưa ra một bài kiểm tra khá đơn giản để tự xác định vị trí hiện tại.
Nếu chúng ta liên tục viết lại cùng một yêu cầu cho đến khi AI trả lời đúng, đó là cấp độ 1: Prompt Engineering.
Nếu chúng ta chuẩn bị file dự án, tài liệu và ví dụ phù hợp trước mỗi nhiệm vụ, đó là cấp độ 2: Context Engineering.
Nếu Agent có thể tự sử dụng công cụ, chạy kiểm thử và không được phép kết thúc khi chưa vượt qua những điều kiện xác định, đó là cấp độ 3: Harness Engineering.
Nếu công việc có thể tự bắt đầu mà không cần chúng ta gửi tin nhắn, đó là cấp độ 4: Loop Engineering.
Và nếu một yêu cầu có thể được chia thành nhiều nhiệm vụ chạy song song, được kiểm chứng rồi tổng hợp trở lại, đó là cấp độ 5: Graph Engineering.
Tôi nghĩ cách phân chia này khá hữu ích, nhưng không nên xem nó như một bảng xếp hạng tuyệt đối về trình độ sử dụng AI.
Không phải ai cũng cần đạt cấp độ 5.
Nếu chỉ muốn AI giúp viết một email hoặc giải thích một khái niệm, cấp độ 1 có thể đã hoàn toàn đủ.
Nếu đang xây dựng một dự án cá nhân nhỏ, việc cung cấp context tốt và cho Agent sử dụng công cụ có thể mang lại phần lớn lợi ích.
Và nếu công việc không có nhiều nhiệm vụ độc lập, việc xây dựng một hệ thống Graph phức tạp đôi khi còn tốn công hơn thực hiện tuần tự.
Nhưng tôi nghĩ giá trị của mô hình năm cấp độ nằm ở chỗ nó giúp chúng ta nhận ra những giới hạn hiện tại.
Khi liên tục phải giải thích lại cùng một thông tin, có lẽ chúng ta cần cải thiện context.
Khi liên tục phải tự chạy code và gửi lỗi cho AI, có lẽ chúng ta cần một harness tốt hơn.
Khi phải nhớ quay lại kiểm tra những công việc lặp lại, có lẽ chúng ta cần automation.
Và khi một nhiệm vụ quá lớn đang được thực hiện tuần tự, có lẽ chúng ta nên nghĩ đến việc chia nhỏ và chạy song song.
Nói cách khác, mỗi cấp độ giúp giải quyết một loại nút thắt khác nhau.
7. Năm việc có thể thử ngay trong tuần này
Một điểm tôi thích ở bài viết là tác giả không chỉ đưa ra lý thuyết.
Anh còn đề xuất năm việc cụ thể, tương ứng với năm cấp độ, mà chúng ta có thể thử thực hiện.
Ở cấp độ Prompt
Hãy lấy prompt mà bạn sử dụng thường xuyên nhất.
Xóa những câu chung chung như “Bạn là một chuyên gia hàng đầu” và thay bằng một ví dụ cụ thể về kết quả tốt mà bạn mong muốn.
Điều này giúp AI hiểu rõ tiêu chuẩn đầu ra thay vì chỉ nhận được một lời mô tả vai trò.
Ở cấp độ Context
Hãy tạo một file hướng dẫn dự án dài khoảng một trang.
Trong đó ghi rõ các quy tắc, công nghệ đang sử dụng, những quyết định quan trọng và trạng thái công việc hiện tại.
Nạp file này vào những phiên làm việc tiếp theo, rồi quan sát xem số lần phải sửa hoặc giải thích lại yêu cầu có giảm không.
Ở cấp độ Harness
Hãy thêm một Stop hook để Agent không thể tự kết thúc khi bộ kiểm thử còn thất bại.
Đây là một thay đổi tương đối nhỏ nhưng có thể cải thiện đáng kể cách chúng ta kiểm chứng kết quả.
Ở cấp độ Loop
Hãy chọn một công việc lặp lại trong backlog hoặc hộp thư.
Tạo một vòng lặp có ngân sách rõ ràng và một file lưu trạng thái.
Cho nó chạy theo lịch, rồi kiểm tra kết quả vào sáng hôm sau.
Với những tác vụ có thể thay đổi dữ liệu quan trọng hoặc tác động đến người khác, nên bắt đầu trong môi trường thử nghiệm và yêu cầu phê duyệt trước khi thực hiện hành động có rủi ro.
Ở cấp độ Graph
Hãy thử xây dựng một quy trình hình kim cương.
Chia một nhiệm vụ review thành nhiều phần, giao cho các Agent thực hiện song song, sử dụng một Agent khác để phản biện từng phát hiện rồi tổng hợp những kết quả đã được xác minh.
Tôi nghĩ không nhất thiết phải bắt đầu bằng một hệ thống phức tạp.
Chỉ cần thử với một dự án nhỏ, chúng ta cũng có thể cảm nhận được sự khác biệt giữa việc điều khiển AI từng bước và việc thiết kế một quy trình để AI tự thực hiện.
8. Có lẽ kỹ năng quan trọng nhất không còn là viết prompt
Điều khiến tôi suy nghĩ nhiều nhất sau khi đọc bài viết không phải là cấp độ 5 có thể điều phối hàng trăm Agents.
Mà là cách tác giả mô tả sự thay đổi trong vai trò của con người.
Ở cấp độ đầu tiên, chúng ta viết từng câu lệnh.
Ở cấp độ thứ hai, chúng ta tổ chức thông tin.
Ở cấp độ thứ ba, chúng ta thiết kế môi trường làm việc.
Ở cấp độ thứ tư, chúng ta xây dựng những vòng lặp tự động.
Và ở cấp độ thứ năm, chúng ta thiết kế cấu trúc của toàn bộ công việc.
Càng lên những cấp độ cao, con người càng ít phải trực tiếp tham gia vào từng thao tác nhỏ.
Nhưng điều đó không có nghĩa là vai trò của con người biến mất.
Ngược lại, chúng ta phải suy nghĩ nhiều hơn về cách xác định vấn đề, phân chia nhiệm vụ, kiểm chứng kết quả và tổ chức những hệ thống phức tạp.
Tôi nghĩ đây là một sự thay đổi khá giống những gì từng xảy ra trong lịch sử công nghệ.
Khi máy móc bắt đầu thay thế một số công việc thủ công, con người dần chuyển từ trực tiếp thực hiện từng thao tác sang thiết kế, điều khiển và giám sát máy móc.
Khi phần mềm phát triển, nhiều quy trình trước đây phải làm bằng tay được chuyển thành những chương trình tự động.
Và giờ đây, AI Agents đang khiến ngay cả một phần công việc viết phần mềm và vận hành những chương trình ấy cũng có thể được tự động hóa.
Nhưng có một điểm khác biệt khá thú vị.
Trước đây, để tự động hóa một công việc, chúng ta thường phải biết cách mô tả quy trình bằng code.
Còn với AI, đôi khi chúng ta có thể bắt đầu bằng ngôn ngữ tự nhiên, rồi để Agent hỗ trợ xây dựng chính những công cụ và quy trình tự động hóa ấy.
Điều này mở ra cơ hội cho nhiều người không có nền tảng kỹ thuật quá sâu.
Nhưng nó cũng tạo ra một yêu cầu mới: Chúng ta cần biết cách đánh giá liệu hệ thống mình xây dựng có thực sự đáng tin cậy hay không.
Một Agent có thể tự chạy kiểm thử không có nghĩa là bộ kiểm thử ấy đầy đủ.
Một hệ thống nhiều Agent có thể đưa ra báo cáo rất nhanh không có nghĩa là mọi kết luận đều chính xác.
Và một vòng lặp có thể hoạt động suốt đêm không có nghĩa là nó nên được phép làm mọi thứ mà không cần giới hạn.
Tôi nghĩ những người sử dụng AI hiệu quả trong tương lai không chỉ là những người biết giao việc cho AI.
Họ còn phải biết cách thiết kế những cơ chế để AI có thể tự kiểm tra, phát hiện sai sót và dừng lại khi cần thiết.
Từ người viết câu lệnh đến người thiết kế hệ thống
Tác giả kết thúc bằng một ý khá hay.
Một người sử dụng AI ở cấp độ Prompt Engineering viết những câu lệnh.
Còn một kỹ sư ở cấp độ Graph Engineering thiết kế hình dạng của công việc, và những câu lệnh cần thiết có thể được hệ thống tự tạo ra trong quá trình vận hành.
Tôi nghĩ đây là cách diễn đạt khá chính xác cho sự thay đổi đang diễn ra.
Trong những ngày đầu sử dụng ChatGPT, tôi từng nghĩ kỹ năng quan trọng nhất là biết cách đặt câu hỏi thật rõ ràng.
Sau đó, tôi nhận ra cung cấp đúng tài liệu và thông tin còn quan trọng hơn việc viết một prompt dài.
Rồi khi bắt đầu sử dụng những công cụ có khả năng chạy code, tôi thấy việc cho AI tự kiểm tra kết quả giúp giảm đi rất nhiều thao tác thủ công.
Và khi nhìn vào những hệ thống có thể điều phối nhiều Agents, tôi bắt đầu hiểu rằng chúng ta có thể còn tiến xa hơn việc chỉ tự động hóa từng nhiệm vụ riêng lẻ.
Chúng ta có thể tự động hóa cả cách những nhiệm vụ được phát hiện, phân chia, thực hiện và kiểm chứng.
Tất nhiên, không phải mọi công việc đều cần đến mức độ phức tạp ấy.
Nhưng tôi nghĩ điều quan trọng là nhận ra chúng ta đang có thêm những lựa chọn mà trước đây không tồn tại.
Mỗi khi một mô hình mới xuất hiện, chúng ta vẫn sẽ tiếp tục hỏi nó thông minh hơn bao nhiêu, viết code tốt hơn thế nào hoặc có thể xử lý những nhiệm vụ khó đến mức nào.
Những câu hỏi ấy vẫn đáng quan tâm.
Nhưng có lẽ chúng ta cũng nên đặt thêm một câu hỏi khác:
“Nếu mô hình hiện tại đã đủ thông minh để thực hiện công việc này, liệu thứ đang giới hạn kết quả có thực sự là mô hình, hay chính cách tôi đang tổ chức công việc cho nó?”
Bởi đôi khi, để AI làm được nhiều hơn, chúng ta không cần chờ một mô hình mới.
Chúng ta chỉ cần ngừng bắt nó làm việc theo cách cũ.
Bài viết được dịch ý, diễn giải và mở rộng từ “Prompt → Context → Harness → Loop → Graph: The 5 Levels of AI Engineering” của Livsun (@L1vsun), đăng ngày 31/10. Các khái niệm, số liệu nghiên cứu, ví dụ code và cấu trúc năm cấp độ được giữ theo bài gốc; những phần liên hệ với trải nghiệm sử dụng AI và suy ngẫm về cách làm việc là góc nhìn cá nhân của tôi.
Lưu ý: Một số tính năng như workflow động, lệnh /loop và cơ chế hook phụ thuộc vào phiên bản, nền tảng và cấu hình của công cụ. Các ví dụ nên được kiểm tra với tài liệu chính thức trước khi áp dụng vào hệ thống thực tế.